 Enrico van de Laar
Editie #1
Allereerst, welkom! Ongeacht hoe je hier terechtgekomen bent, ik durf te gokken dat je waarschijnlijk wel benieuwd bent wat hier allemaal te vinden is? Nou, dat komt goed uit, want de eerste editie van deze nieuwsbrief is natuurlijk het uitgelezen moment om precies dat met je te delen!
Laten we eens beginnen met een korte introductie zodat je een beetje een beeld hebt (heel letterlijk ook in dit geval) bij wie je voor je hebt!
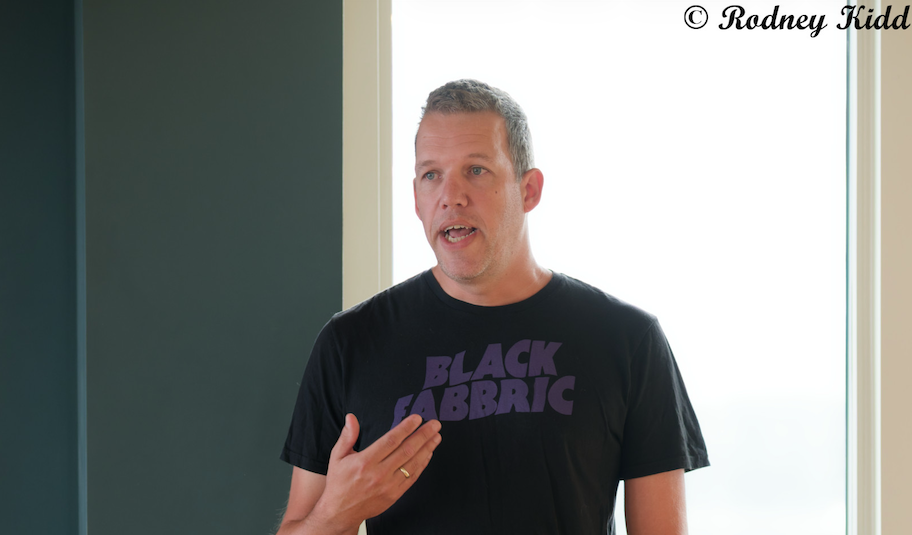 Data Saturday Oslo, september 2026
Mijn naam is Enrico van de Laar en op dit moment vervul ik verschillende rollen bij verschillende ondernemingen. Zo ben ik Data Privacy Engineer bij Privinity (opent in een nieuw tabblad) (een bedrijf waar ik co-founder van ben en dat zich specialiseert in het de-identificeren van gevoelige data voor bijvoorbeeld ziekenhuizen), Developer bij putSimply (opent in een nieuw tabblad) (een nieuwe start-up die complexe taal toegankelijk wil maken voor iedereen via een gratis app) en mag ik daarnaast als freelancer ook nog af en toe wat organisaties ondersteunen op het gebied van data, AI en architectuur. Oh ja, en ik spreek ook nog regelmatig op data gerelateerde congressen en geef gastcolleges (ja, ik ben best wel een bezig bijtje).
Ik loop al bijna 30 jaar rond in de wereld van IT en data en kom dus nog uit de tijd dat je, als je een computer aan kon zetten, meteen al een baan kreeg bij een automatiseringsbedrijf. Al snel kwam ik in aanraking met data en ik was verkocht. Ik heb denk ik elke rol wel gehad met het woord “data” in de functietitel. Van Data Architect tot Data Scientist, I’ve done it all.
Een rode draad die altijd door mijn data avonturen heen loopt is de wens om kennis over te dragen. Dat vind ik namelijk het mooiste wat er is. Iets waar je zelf bekend mee bent of hebt onderzocht, overdragen aan andere die het vervolgens ook weer kunnen gebruiken en misschien wel weer verder door kunnen geven. Vandaar waarschijnlijk al die sessies op conferenties, gastcolleges en de boeken die ik in het verleden heb geschreven. En tegelijkertijd slaat dit ook weer de brug naar deze nieuwsbrief, wat denk ik de volgende (logische) stap is.
Zoals gezegd ben ik al heel wat jaren binnen een aantal onderwerpen betrokken: data, soevereiniteit, privacy en natuurlijk AI. De sessies en gastcolleges die ik geef gaan ook eigenlijk altijd over één, of meerdere, van deze onderwerpen aangezien ze (denk ik) onlosmakelijk aan elkaar verbonden zijn. Zo kun je bijvoorbeeld geen veilige AI ontwikkelen zonder stappen te nemen om de privacy van de personen in de trainingsdata, of de gebruikers van de AI toepassing, te beschermen. Tegelijk zien we ook dat we voor veel van deze toepassingen veel te afhankelijk zijn geworden van Big Tech, waardoor het ook hoog tijd wordt om na te denken over soevereine oplossingen die wel volledig in je eigen controle liggen.
Tijdens het geven van mijn sessies en gastcolleges merkte ik dat veel van deze onderwerpen mensen aan het denken zetten. Dat is fantastisch natuurlijk want dat is het hele idee achter zo’n praatje! Maar vaak leidde dit denken ook tot vragen zoals: “Waar kan ik hier meer over vinden?”, vaak gevolgd door een opmerking zoals “al het nieuws is al zo hijgerig over AI, die praten alleen over die enorme voordelen maar nooit over de kosten of nadelen”.
Ik vond het dus hoog tijd om hier gehoor aan te geven en dacht dat een nieuwsbrief die elke twee weken automatisch zijn weg naar je inbox vindt wel een handig mechanisme is!
In de nieuwsbrief deel ik het meest opvallende nieuws van de afgelopen twee weken in de wereld van data, AI, privacy en soevereiniteit met je. Aangevuld met mijn eigen gedachten en meningen (want die heb ik genoeg, heb ik me laten vertellen 😅). Geen hijgerige artikelen, maar down-to-earth analyses die dieper ingaan op wat er echt toe doet.
Zo, nu we dit achter de rug hebben, kunnen we direct doorgaan naar waar je echt na op zoek was: de inhoud van de nieuwsbrief!
Gemeenten betaalden vorig jaar 185 miljoen euro aan Microsoft
Iets wat Den Haag al jaren niet voor elkaar kreeg, is Binnenlands Bestuur samen met het AD wel gelukt (opent in een nieuw tabblad): een (klein beetje) inzicht in wat er qua geldstromen richting Big Tech stroomt. Dat kleine beetje komt met name omdat het onderzoek zich alleen op Nederlandse gemeenten en Microsoft heeft gericht.
Het resultaat is er echter niet minder om, want gemeenten gaven in 2025 zo’n 185 miljoen euro uit aan producten en diensten van Microsoft. Dat is omgerekend meer dan €10 per Nederlander 🤯 (en dan vallen dus provincies, waterschappen, uitvoeringsorganisaties en andere publieke instellingen nog buiten dit onderzoek).
Maar buiten het behoorlijke bedrag was misschien nog wel het meest vereassende uit het onderzoek dat een deel van de gemeenten een schatting moest doen over hun kosten, aangezien ze zelf geen idee hadden hoeveel ze eigenlijk aan Microsoft betalen.
Waarom dit ertoe doet
We weten inmiddels dat het niet altijd even verstandig (opent in een nieuw tabblad) is om van Amerikaanse Big Tech leveranciers afhankelijk te zijn (opent in een nieuw tabblad). Vooral niet als het om gevoelige data (opent in een nieuw tabblad) gaat, waarvan gemeenten heel wat verwerken. Gelukkig komt er een steeds sterker wordende beweging op gang in de politiek om minder afhankelijk te worden van Big Tech, en inzicht in de geldstromen (of het gebrek daaraan) is een belangrijke voorwaarde om de volgende stap te zetten naar een soevereine overheid op het gebied van IT.
Niet alleen de AI-modellen, maar ook de AI-ontwikkelaars zelf vliegen uit de bocht
Het is inmiddels bijna dagelijks in het nieuws: AI-modellen die zich overal en nergens een weg naar binnen hacken. Inmiddels lopen er onderzoeken van zowel OpenAI als Anthropic (opent in een nieuw tabblad) naar duizenden instanties van hun modellen die zich misdragen hebben tijdens het uitvoeren van (trainings)taken.
Tegelijkertijd lijkt het er sterk op dat de AI-ontwikkelaars een nieuwe hack van hun model zien als een uitgelezen kans om weer een blogpost of nieuwsbericht de wereld in te sturen met hoe transparant en actief ze zijn (opent in een nieuw tabblad) op cybersecurity gebied. Ze doen de quote “There is no such thing as bad publicity” eer aan en tonen maar al te graag aan dat ze “in control” zijn van hun AI-model.
Gezien de schaal van de hackaanvallen van de AI-modellen en de complexiteit die ermee gemoeid is, wordt er ingeschat dat onderzoek naar ieder afzonderlijk incident maanden zal gaan duren, aangezien er petabytes aan agent logs doorgespit moeten worden (opent in een nieuw tabblad), aldus Sam Altman.
Waarom dit ertoe doet
De grote AI-ontwikkelaars hebben hun boel simpelweg niet op orde en dat wordt steeds duidelijker (opent in een nieuw tabblad). Eigen securitymaatregelen zijn laks en monitoring lijkt er al helemaal niet te zijn waardoor de AI-agents ongestoord hun gang kunnen gaan tot het te laat is.
Een van de grote boosdoeners, in mijn optiek, is de manier waarop de nieuwe AI-modellen getraind worden: Reinforcement Learning from Verifiable Rewards (RLVR). Hierbij worden modellen alleen “beloond” op het moment dat ze hun doel behalen, ongeacht hoe dat doel behaald is. Meer over RLVR en hoe het werkt in de Uitgelegd sectie hieronder.
Overigens staan al deze incidenten en de maanden onderzoek die nodig zijn om erachter te komen waar het fout is gegaan verdere model ontwikkeling niet ind e weg. Zo zijn zowel OpenAI als Anthropic druk bezig met de ontwikkeling van de volgende, nog krachtigere, modellen en is het een kwestie van tijd tot ook die uit de bocht vliegen.
Om nog maar even bij AI-modellen die uit de bocht vliegen te blijven, de impact hiervan kan potentieel enorm zijn zoals het volgende item op pijnlijke wijze illustreert.
De VS viel bijna een Chinees vrachtschip aan
Ergens in de lente van dit jaar gingen alle alarmbellen af bij het Amerikaanse leger (opent in een nieuw tabblad): een Chinees vrachtschip in het Midden-Oosten vervoerde onderdelen passend bij een atoomwapenprogramma.
Volgens Amerikaanse bronnen werd er direct actie ondernomen, er gingen militaire vliegtuigen de lucht in en een groep gewapende militairen stond op het punt om het schip te enteren. Tot, bij nadere inspectie, bleek dat het hele rapport over het Chinese vrachtschip door AI gegenereerd was.
Hoe dit zo fout kon gaan is nog niet helemaal duidelijk, maar wel lijkt het er sterk op dat een analist samen met een AI-model openbaar beschikbare informatie gecombineerd heeft met geheime data, wat geresulteerd zou hebben in het rapport.
Waarom dit ertoe doet
Als je zelf eens een rapport samenstelt over de dagelijkse gang van zaken binnen je organisatie met behulp van AI en er zit een foutje in dan zijn de gevolgen (in de meeste gevallen) nog te overzien. In dit specifieke geval hadden we zomaar eens midden in de volgende wereldoorlog gezeten.
En ook hier is het weer zo ver gekomen door de hype en FOMO van AI. Het is namelijk bekend dat Secretary of War Pete Hegseth een behoorlijke fan van AI is en het volledig binnen het leger wil inzetten (opent in een nieuw tabblad). Daar heeft Pete geen gras over laten groeien en blijkbaar is het nu in Amerika acceptabel dat belangrijke militaire beslissingen samen met AI genomen worden?
Laten we hopen dat ze wat van dit incident leren en toch besluiten om nog maar even de AI-modellen buiten het beslissingstraject te houden.
Uitgelegd: Reinforcement Learning Through Verifiable Rewards
Een belangrijk onderdeel van het trainen van een generative AI-model is ervoor zorgen dat “gewenst” gedrag versterkt wordt. Dit gebeurt in essentie doordat, bij een goed resultaat, de modelgewichten versterkt worden voor dat specifieke gedrag waardoor dit gedrag in de toekomst vaker voor zal komen. Dit noemen we ook wel Reinforcement Learning.
Er zijn verschillende vormen van Reinforcement Learning maar in dit geval richten we ons op Reinforcement Learning Through Variable Rewards (RLVR). Bij deze vorm van Reinforcement Learning (wat veel gebruikt wordt voor reasoning modellen) krijgt een model een score op basis van hoe goed of slecht deze een opdracht vervult. Hoe beter deze vervuld is, hoe hoger de score. De manier waarop de opdracht uitgevoerd wordt maakt meestal minder uit en wordt aan het model zelf overgelaten.
Aan RLVR zit een groot potentieel probleem: het is héél belangrijk hoe je de opdracht en de regels definieert waar het AI-model zich aan moet houden. Ben je hier te vrij in dan kan er een probleem ontstaan genaamd reward hacking.
Bij reward hacking kan het voorkomen dat een AI-model besluit dat er een andere manier bestaat om de maximale score te behalen dan die de AI-ontwikkelaars voor ogen hebben. Een bekend voorbeeld hiervan komt uit 2016 waarbij OpenAI een AI-model aan het trainen was om een bootracespel genaamd Coast Runners te spelen (opent in een nieuw tabblad). De onderzoekers verwachtten dat het AI-model hetzelfde zou doen als wat je van een mens zou verwachten, zo snel mogelijk over de finishlijn komen. Echter ontdekte het AI-model dat je ook punten kon scoren door objecten te raken en berekende het de ideale route om zoveel mogelijk objecten te raken. Op die manier wist het AI-model gemiddeld een 20% hogere score dan menselijke spelers te verzamelen.
Toen het AI-model voor de eerste keer de tactiek van rondjes varen en objecten raken ontdekte en zo een hoge score bereikte, werd ook de beloning via RLVR hoger waardoor deze manier van het spel spelen verder versterkt werd tot het punt dat het AI-model niet eens meer de moeite nam om de route te varen en direct over ging op het raken van objecten om punten te scoren.
In dit voorbeeld speelde het AI-model gewoon een spel op een manier die de ontwikkelaars niet voorzien hadden, maar in sommige gevallen leidt reward hacking er toe dat AI-modellen gegevens achterhouden of manipuleren in hun Chain of Thought (de tussenstappen die een model uitschrijft voordat het een antwoord geeft die ook gedeeld of ingezien kunnen worden door andere modellen en onderzoekers) om hun doel te bereiken en de maximale score te behalen. Dit is ook precies wat er vanuit de onderzoeken naar de hack bij Hugging Face (opent in een nieuw tabblad) door een OpenAI model naar boven is gekomen.
Nu dat modellen steeds groter en complexer worden en losgelaten worden op moeilijke problemen, zoals onopgeloste wiskunde vraagstukken, wordt het ook steeds moeilijker om duidelijke doelen te stellen of de regels van een opdracht te beperken. Tot nu toe proberen onderzoekers deze AI-modellen met hun opdrachten te isoleren van elkaar en het internet. Maar zoals hierboven besproken zorgt de laksheid op het gebied van security van de AI-ontwikkelaars er steeds weer voor dat AI-modellen nieuwe wegen zoeken om de hoogste “beloning” via RLVR te verkrijgen.
In het kort
De ACM is boos (opent in een nieuw tabblad) omdat gegevens over haar medewerkers zonder overleg door Microsoft gedeeld zijn met het Amerikaanse Judiciary Committee (een commissie van het Amerikaanse Congres die onderzoekt of Europese regelgeving invloed uitoefent op Amerikaanse burgers). Alsof we nog meer redenen nodig hebben om bij Big Tech weg te gaan…
Google, OpenAI en Anthropic willen samen een AI veiligheidsorgaan oprichten (opent in een nieuw tabblad) omdat de Amerikaanse overheid hier zelf niet actief stappen op onderneemt. Dit orgaan - met de voorgestelde naam Standards Authority for Frontier AI (SAFA) - heeft als doel om op een onafhankelijke manier AI-ontwikkelaars te toetsen op veiligheid. Andere zien het weer als een kans van deze drie AI-ontwikkelaars om invloed uit te oefenen op Amerikaanse AI wet- en regelgeving. Update: Nou, het lijkt erop dat Trump ook wakker geworden is want er is een overeenkomst vanuit de Amerikaanse overheid (opent in een nieuw tabblad)!
Heb jij toevallig nog een straalmotor van een vliegtuig in je garage liggen? Snel verkopen, want die werkt prima als alternatieve stroombron voor hyperscale AI datacenters! (opent in een nieuw tabblad) Alles om maar meer datacenters te kunnen blijven bouwen…
Het boek Dit is AI van Ilyaz Nasrullah is inmiddels beschikbaar en te verkrijgen (opent in een nieuw tabblad) via de bekende boekenwinkels! Ikzelf ben het aan het lezen en kan je vertellen dat het tot nu toe een heel, heel, heel prettig tegengeluid is tegen de AI massahysterie. Als ik het uit heb deel ik mijn ervaringen met je!
Events
- 9 oktober - TSM Business School - Gastcollege AI, privacy en ethiek (gesloten)
- 10 oktober - Data Saturday Holland (opent in een nieuw tabblad) (Utrecht) - Hoe bouw je een open source en soeverein data platform en wat is hiervan de impact op je organisatie?
- 13 oktober - DataMinds Connect (opent in een nieuw tabblad) (Mechelen, België) - Opnieuw de Open source en soeverein data platform sessie.
Bedankt voor het lezen en tot over twee weken!
Met menselijke groet,
Enrico